幻兽帕鲁服务器 24 小时不关机:开机自启、崩溃自动重启、定时重启
《幻兽帕鲁》服务器要 24 小时挂着,靠的是三套互相替代不了的机制:开机自启、崩溃后自动拉起、每天定时重启。systemd 单元管得到哪些、管不到哪些,以及它掉了你怎么第一时间知道。
「24 小时挂着」不是一个设置,是三套性质不同的机制:开机时自己起来、死掉时自己回来、还没死就先停下来再起一次。三件事少做一件,就正好会在那一件上断掉。服务器还没搭起来的话,先看开服教程;这篇谈的是让一台已经在跑的服务器一直跑下去。
24 小时不关机其实是三件事
掉线的方式有三种,每种由不同的东西挡住。
| 什么让它停了 | 需要什么 | 设置在哪 |
|---|---|---|
| 内核更新或断电之后机器重启 | 开机自启 | systemd 的 enable |
| 内存不够被系统杀掉,或者游戏进程崩溃 | 崩溃自动重启 | 单元里的 Restart |
| 什么都没死,只是越跑越重 | 每天定时重启 | timer 或 cron |
三者不能互相替代。Restart=on-failure 跟开机一点关系都没有(那是 enable 的事),enable 不会把一小时前死掉的进程救回来,而内存慢慢爬升的那段时间里两者都不会动——因为那时候还没有任何东西失败。
还有一件需要人的第四件事:知道它掉了。三件都做齐,还是会遇到三件一起失手的那一晚,剩下的问题只是谁先发现、隔多久发现。
systemd 单元管得到什么,管不到什么
单元文件用开服教程里那份,再在 [Unit] 段补两行。这篇要看的是下面这几行。
[Unit]
StartLimitIntervalSec=600
StartLimitBurst=5

[Service]
Restart=on-failure
RestartSec=10

[Install]
WantedBy=multi-user.target
WantedBy=multi-user.target 配上 sudo systemctl enable palworld,合起来才是开机自启。教程里 enable --now 的 --now 只是「顺便现在也开起来」;只做 start 没做 enable,今天一切正常,下次重启机器它就不在了。这种失败没办法在脑子里验证,挑一个没人在线的时间真的 sudo reboot 一次,看它会不会自己回来。
Restart=on-failure 管得到的是非零的退出码,以及被信号杀掉的情况——内存用光被内核杀掉属于后者。
管不到的有三种:
- 正常退出(退出码 0)。 通过 REST 接口关掉的服务端是干净退出的,
on-failure故意不碰它。「脚本明明把服务停下来了却没再起来」十次有九次是这个。 - 进程还活着但没响应。 systemd 看的是进程,不是游戏。进得去却没人动得了的时候,单元的状态照样是
active。 - 反复失败。 有了
StartLimit那两行,10 分钟内启动失败 5 次,systemd 就会放弃,停在failed。systemd 自己的默认值是「10 秒内 5 次」,每次都要先等RestartSec=10的单元永远碰不到这条线;少了那两行,每次都死在同一个原因上的服务器只会停在activating (auto-restart)无限重试。systemctl status palworld里出现「start request repeated too quickly」不代表自动重启坏了,它是在说每次都死在同一个原因上,该去看日志了。
别把那两行删掉或者设成 StartLimitIntervalSec=0 来把第三种盖过去。那只会让一台因为存档损坏而起不来的服务器每 10 秒重试到天荒地老,真正的原因被冲到几千行以下。先用 journalctl -u palworld -n 100 读最后一次失败的理由,永远更快。
每天定时重启不是可选项
Restart=on-failure 要等进程死了才动,而内存泄漏让所有人一起变慢的那一段发生在死之前,所以每天还得主动重启一次;为什么会泄漏、间隔怎么定,写在内存泄漏与定时重启。反正每天都要停一次,版本校验也可以并进去,做法在服务器更新教程:版本不一致与不掉存档的顺序。
要定时,cron 最短,脚本在上面那篇里就有。想全部留在 systemd 里的话,用 timer 也可以。
# /etc/systemd/system/palworld-restart.timer
[Unit]
Description=Restart Palworld daily

[Timer]
OnCalendar=*-*-* 04:00:00

[Install]
WantedBy=timers.target
同名的 palworld-restart.service(Type=oneshot)去调真正的脚本,再用 sudo systemctl enable --now palworld-restart.timer 开起来,下一次执行时刻用 systemctl list-timers 看。不要加 Persistent=true。 那个选项是替机器关机期间错过的任务在开机后补跑一次,而一台两分钟前才起来的服务器没有理由再重启。
时刻挑没人在线的凌晨,只要避开备份在跑的时段就好。
先公告、再倒计时、存完档才停
用 kill、systemctl kill 或者直接按电源把它关掉,等于每天自制一次崩溃:自动存档间隔内的进度直接消失,运气差一点还会撞上正在写盘,留下写到一半的 Level.sav——而它要到下次启动才会暴露,那时候已经过了一天。
正确的停法是四步,全服公告 → 倒计时 → 强制存档 → 停止,四步都在官方 REST 接口里(怎么开、怎么认证见 REST API 管理)。
PW='一个足够长的密码'
API='http://127.0.0.1:8212/v1/api'

# 先把世界写到磁盘上
curl -s -u "admin:$PW" -X POST "$API/save"

# 公告和倒计时由接口代劳
curl -s -u "admin:$PW" -X POST "$API/shutdown" \
     -H 'Content-Type: application/json' \
     -d '{"waittime":60,"message":"Server is going down in 60 seconds"}'
message 不是聊天栏里一闪而过、刷上去就没了的一行,而是横在每个玩家画面正中央的一条横幅:
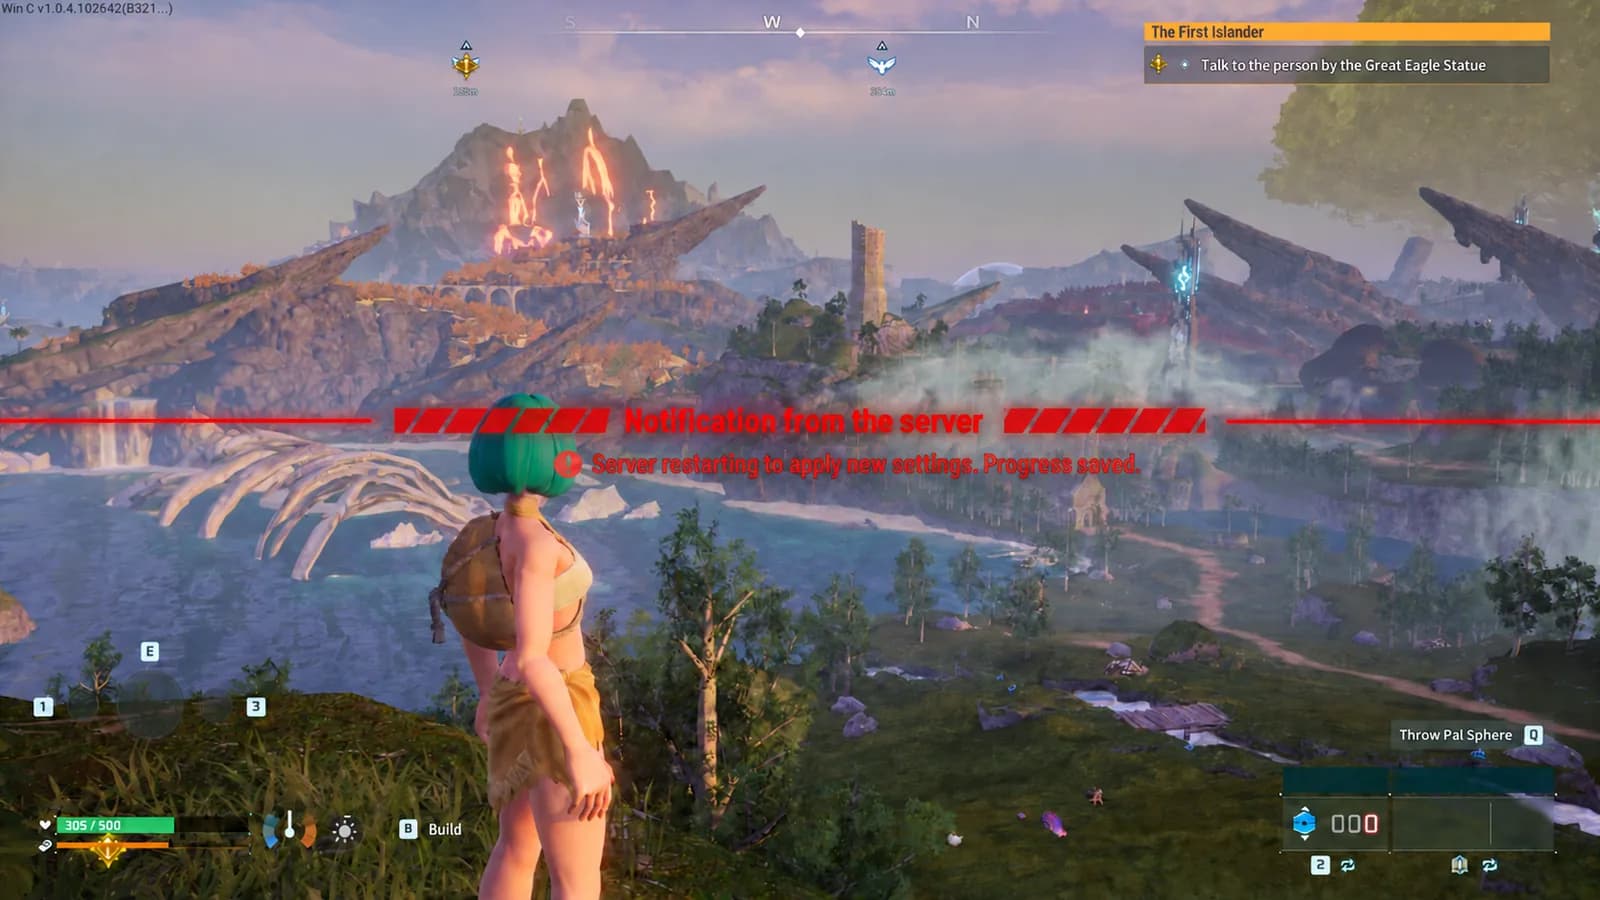
/stop 是不预告、立刻切断的那个,日常运维不要用它;/shutdown 会等满你给的秒数,再按正常流程降下去。
而上一节的陷阱在这里正好合上:/shutdown 关掉的进程是正常退出,Restart=on-failure 不会把它拉起来。如果目的是重启,就让接口只负责存档和公告,最后一行交给 sudo systemctl restart palworld;如果目的真的是停机(维护、搬家),/shutdown 本身就够了。没分清这两者,是「凌晨停了就再也没起来」最常见的成因。
它掉了你怎么第一时间知道
默认的监控是「玩家会告诉你」,而这个通知的形式是周五晚上十点五个人在等。有三种更便宜的做法。
一行状态。 systemctl is-active palworld 只会吐 active 或 failed。要看原因,就从当天的日志里捞退出事件。
systemctl is-active palworld
journalctl -u palworld --since today | grep -i "main process exited"
端口。 游戏用的是 UDP 8211,浏览器打不开也就验不了,要看实际有没有在监听,用 ss -lunp | grep 8211。
一分钟的心跳。 本机 cron 每分钟打一次 /metrics,失败就往你真的会看的地方送一行。cron 拿不到你在 shell 里设的 PW,所以密码写进一个小脚本,crontab 那行只负责调用它。
#!/bin/bash
# /home/palserver/heartbeat.sh:cron 每分钟调一次
PW='一个足够长的密码'
curl -sf -m 10 -u "admin:$PW" http://127.0.0.1:8212/v1/api/metrics >/dev/null || /home/palserver/alert.sh
加上 -m 10,活着却不响应的服务器也会被当成挂了。脚本里有管理员密码,先用 chmod 700 /home/palserver/heartbeat.sh 让别人读不到,再挂进 cron:
* * * * * /home/palserver/heartbeat.sh
千万别为了让外部监控服务探得到就把 8212 对公网开放。官方明确说过这个接口不是设计来直接面向公网的,这笔交易是拿整台服务器的管理权去换一个监控。心跳留在机器内部跑,往外送的只有那一行通知。
家用电脑有两道过不去的坎
断电。 跳一次闸就是一次 kill -9,而且有机会正好撞在写存档的那一秒。UPS 买到的是几分钟,这几分钟要花在「断电时按顺序降下去」才有意义——也就是要把 UPS 的监控程序接到上面那份停机脚本上。至于电回来以后机器会不会自己开,那不是操作系统的设置,是 BIOS 里的来电自启选项。跟重启一样,这件事也得真的把插头拔一次才算验过。
动态 IP。 家用宽带的公网 IP 说变就变,一变,朋友存的那串 地址:端口 全部作废。DDNS 可以让一个域名跟着跑,但《幻兽帕鲁》客户端存下来的是你当初填进去的字符串,所以还是要全员重新填一次。再叠上路由器重启、上行带宽、运营商那边的地址共享,排查就会拉长,顺序整理在专服连不上排查。
这两件事都不是「设置调得更好」就能翻过去的。家用电脑撑几天没问题,要长期没人盯着撑几个月,每次卡住的都是它们。
常见问题
帕鲁服务器怎么做到 24 小时不关机?
把三件事分开做:enable systemd 单元,让它开机自启;单元里写 Restart=on-failure,让它崩溃后自动拉起;再用 timer 或 cron 排一天一次的定时重启。三件各挡一种状况,只做其中一件,另外两种状况发生时它一样是关着的。
服务器崩溃后能自动重启吗?
能。单元的 [Service] 段写上 Restart=on-failure 和 RestartSec=10,崩溃或者被内存不足杀掉之后 10 秒会重新起来。[Unit] 段再加上 StartLimitIntervalSec=600 和 StartLimitBurst=5,每次都死在同一个原因上的服务器就不会无限循环,10 分钟内失败 5 次就停下来。但这是争取时间,不是解决原因;如果一天触发好几次,该查的是内存而不是重启设置。
自动重启设好了,服务器却没回来,该看什么?
先看 systemctl status palworld。出现「start request repeated too quickly」表示 10 分钟内失败了 5 次、systemd 放弃了,真正的原因在日志里,修好之后用 sudo systemctl reset-failed palworld 清掉计数再启动。状态一直停在 activating (auto-restart) 的话,是少了 StartLimit 那两行,正在无限重试。没有报错只是安静地 inactive,多半是正常退出,on-failure 本来就不会碰它——把脚本最后一行改成 systemctl restart 就好。
用家里的电脑 24 小时开帕鲁服务器行吗?
撑几天可以。时间拉长就会卡在断电和动态 IP:断电是没有预告的强制关机,可能把存档弄坏;公网 IP 一变,大家存的连接地址全部失效。两件都不是设置能解决的,要长期常驻就需要一台电源和线路有人维护的机器。
这三件事在托管上分别在哪
把三件事逐条搬过去,会是这样。
第一件,开机自启根本不再是一个步骤——机器和游戏进程是一起托管的,没有可以忘记 enable 的地方。第二件,进程崩溃由系统自动拉起。第三件,每日定时重启在会员中心的我的服务器里进去的服务器详情页上,就是一个开关加一个时刻;挑个安静的时段设好,之后既没有 timer 文件,也没有 Persistent 要判断。
重启前发生的事,跟这篇手写的顺序一模一样:先在游戏里发全服公告,倒计时走完先强制存档,然后才停——也就是优雅停机。至于没算进三件里的第四件,知道它掉了,也在同一个页面上:FPS 和在线人数每分钟记录一次,停掉的那一段线就是断的,昨晚三点发生过什么用看的就知道,不必去翻日志。
空岛灵境 的《幻兽帕鲁》专用服务器上,这几项就放在上面说的位置。就算你选择自己搭,要确认的清单也一样:一次 enable、一行 Restart、一个 timer,再加一个知道它掉了的方法。四项都顾到,至少不会再落到「不知道为什么是关着的」那种停法。
反过来,如果你的问题其实是「没人在的时候世界有必要一直跑吗」,那答案在自动暂停,以及它的代价。